Инструкция по подключению к БД
Шаг 1: Подготовка
- Скачайте и установите DBeaver Community Edition с официального сайта.
- Найдите свой логин в реестре пользователей.
- Посмотрите ваш логин в таблице (Пароль по умолчанию:
password123).
Шаг 2: Создание подключения в DBeaver
- Откройте DBeaver.
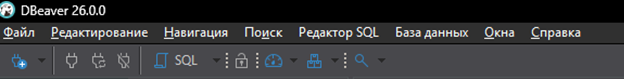
- Нажмите на иконку «Новое соединение» (вилка с плюсиком) в левом верхнем углу.
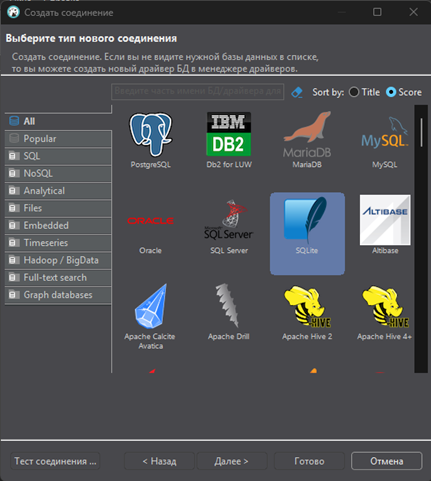
- В появившемся окне выберите PostgreSQL и нажмите «Далее».
Шаг 3: Настройка параметров
Заполните поля во вкладке «Главное» следующими данными:
- Host (Хост): 82.146.36.189
- Port (Порт): 54321
- Database (База данных): db_simulator
- Username (Пользователь): ваш логин из таблицы
- Password (Пароль): password123
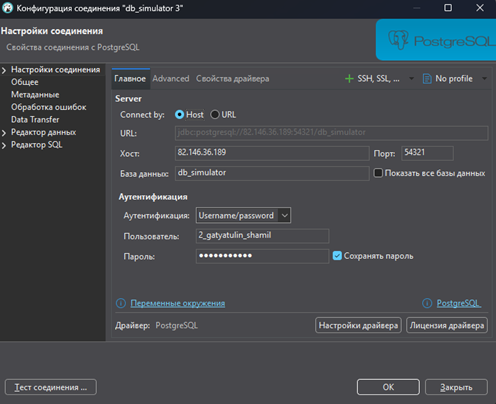
- Нажмите кнопку «Тест соединения». Если программа попросит скачать драйверы — нажмите «Скачать».
- Если вы видите надпись «Connected», нажмите «ОК» и «Завершить».
⚠️ Ошибка Maven artifact (Нажмите, если не подключается)
Если при попытке подключения вы видите ошибку:
«Maven artifact 'org.postgresql:postgresql:RELEASE' cannot be resolved in external repositories»
Выполните следующие действия:
- Закройте окно подключения.
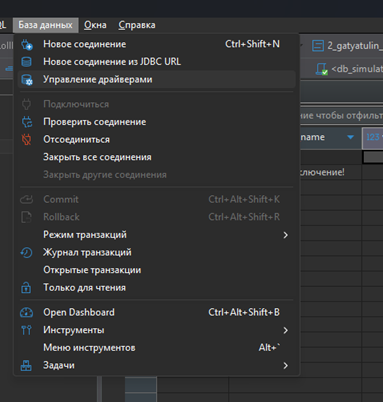
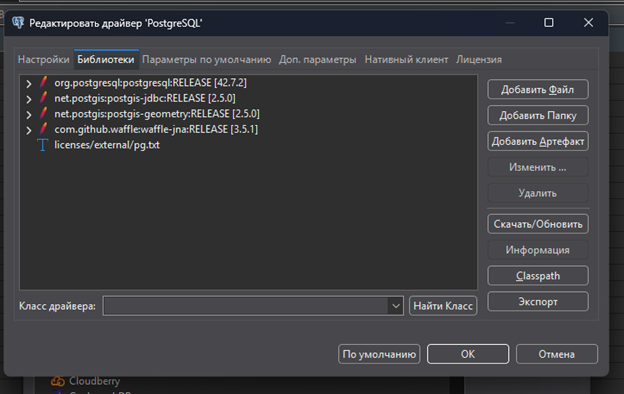
- В верхнем меню выберите База данных (Database) -> Управление драйверами (Driver Management).
- В списке найдите PostgreSQL, выберите его и нажмите кнопку Изменить... (Edit).
- Перейдите на вкладку Библиотеки (Libraries).
- Нажмите на текущий драйвер в списке и нажмите кнопку Удалить (Delete).
- Нажмите кнопку Добавить артефакт (Add Artifact).
- В появившееся поле вставьте следующую строку:
org.postgresql:postgresql:42.7.3
(Примечание: если версия 42.7.3 недоступна, используйте 42.7.1). - Нажмите «ОК», затем DBeaver предложит скачать файлы — нажмите Download.
Шаг 4: Настройка фильтров (Скрываем лишние схемы)
По умолчанию в базе данных много пользователей. Чтобы дерево объектов выглядело аккуратно, настройте фильтр:
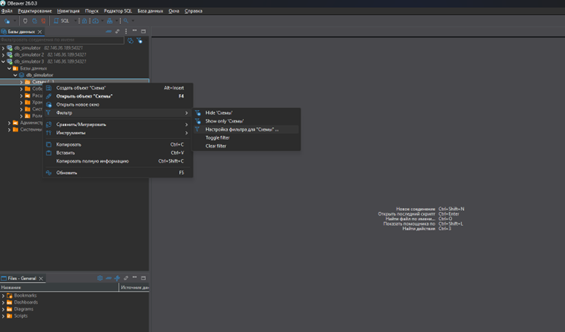
- В левой панели (Навигатор объектов) раскройте ваше соединение и найдите папку Schemas (Схемы).
- Нажмите на папку Schemas правой кнопкой мыши.
- В появившемся меню выберите пункт Filter -> Configure connection filter...
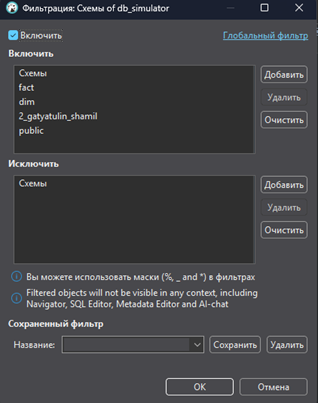
- В открывшемся окне:
- Убедитесь, что стоит галочка Включить.
- В поле впишите через запятую нужные вам схемы:
ВАШ_ЛОГИН, fact, dim, public.
(Например: 1_ivanov_ivan, fact, dim, public).
- Нажмите «ОК». Папка «Схемы» обновится, и в ней останутся только нужные разделы.
Шаг 5: Проверка доступа
Откройте «Редактор SQL» (нажмите Ctrl + Enter или иконку SQL на верхней панели) и выполните тестовый запрос:
-- Проверка своей таблицы (замените test на название вашей таблицы, если нужно)
INSERT INTO test (verification_name) VALUES ('Успешное подключение!');
SELECT * FROM test;

-- Проверка доступа к общим данным (измерения и факты)
SELECT * FROM fact.fact LIMIT 10;Задание 1.1: Фильтрация справочника товаров
💡 Теория: Оператор WHERE
Оператор WHERE позволяет фильтровать строки. Для булевых (логических) значений можно писать WHERE column = true или просто WHERE column.
Описание задачи:
Нам нужно найти все товары, которые были заведены вручную (кастомные). Напишите запрос к таблице справочника товаров dim.dim_item. Выведите item_id, item_name и user_creator только для тех записей, где поле is_custom равно true.
SELECT
    item_id,
    item_name,
    user_creator
FROM dim.dim_item
WHERE is_custom = true;Задание 1.2: Устранение дубликатов
💡 Теория: Уникальные значения
Оператор DISTINCT оставляет только уникальные значения в выборке. Полезно, когда нужно узнать, какие вообще варианты значений существуют в колонке (составить уникальный список).
Описание задачи:
В таблице распределительных центров dim.dim_dc есть поля dc_type_code (код типа РЦ) и dc_type_desc (описание). Руководство просит дать уникальный список всех типов РЦ и их описаний, которые есть в базе. Исключите дубликаты.
SELECT DISTINCT
    dc_type_code,
    dc_type_desc
FROM dim.dim_dc;Задание 1.3: Простая агрегация
💡 Теория: GROUP BY и COUNT
Функция COUNT() считает количество строк. В сочетании с GROUP BY она считает количество строк для каждой уникальной группы.
Описание задачи:
Аналитики хотят узнать размер каждой группы товаров. Посчитайте количество товаров (item_id) в разрезе item_group_id. Используйте таблицу dim.dim_item. Переименуйте колонку с подсчетом в items_count (с помощью оператора AS).
SELECT
    item_group_id,
    COUNT(item_id) AS items_count
FROM dim.dim_item
GROUP BY item_group_id;Задание 2.1: Соединение фактов со справочником
💡 Теория: INNER JOIN
Оператор JOIN объединяет строки из двух таблиц по совпадению ключей. В DWH таблица фактов всегда соединяется со справочником по суррогатному ключу (колонка с суффиксом _key).
Пример: FROM fact f JOIN dim d ON f.dim_key = d.dim_key
Описание задачи:
В таблице fact.fact есть только ID поставщика (vendor_key), но бизнес-пользователям нужны названия. Напишите запрос, который объединит таблицу фактов fact.fact со справочником поставщиков dim.dim_vendor.
Выведите название поставщика (vendor_name), а также количество заказанного (ordered) и доставленного (delivered) товара. Выведите первые 20 строк.
SELECT
    v.vendor_name,
    f.ordered,
    f.delivered
FROM fact.fact f
JOIN dim.dim_vendor v
    ON f.vendor_key = v.vendor_key
LIMIT 20;Задание 2.2: Метрика "Недовоз"
💡 Теория: Математика в агрегациях
Внутри блока SELECT можно выполнять математические операции прямо с агрегатными функциями. Например: SUM(a) - SUM(b) покажет разницу сумм.
Описание задачи:
Логистам нужно выявить товары, по которым поставщики чаще всего привозят меньше, чем было заказано. Соедините таблицу фактов fact.fact с таблицей товаров dim.dim_item.
Выведите название товара (item_name) и разницу между суммой заказанного и суммой доставленного (назовите колонку shortage). Сгруппируйте результат по названию товара и отсортируйте по убыванию недовоза.
SELECT
    i.item_name,
    SUM(f.ordered) - SUM(f.delivered) AS shortage
FROM fact.fact f
JOIN dim.dim_item i
    ON f.item_key = i.item_key
GROUP BY
    i.item_name
ORDER BY
shortage DESC;Задание 2.3: Схема "Снежинка"
💡 Теория: Цепочка JOIN
Иногда нужной информации нет в справочнике, привязанном к фактам напрямую. Например, группы товаров (item_group_name) лежат в отдельной таблице. Мы пишем несколько JOIN подряд: от фактов к товарам, от товаров — к группам.
Описание задачи:
Категорийные менеджеры хотят посмотреть общую сумму доставленного товара (delivered) в разрезе целых товарных групп (item_group_name).
В таблице fact.fact есть только item_key. Вам нужно:
1. Присоединить к фактам справочник товаров dim.dim_item.
2. Присоединить к справочнику товаров справочник групп dim.dim_item_grp.
Выведите item_group_name и сумму доставленного (total_delivered).
SELECT
    g.item_group_name,
    SUM(f.delivered) AS total_delivered
FROM fact.fact f
JOIN dim.dim_item i
    ON f.item_key = i.item_key
JOIN dim.dim_item_grp g
    ON i.item_group_id = g.item_group_id
GROUP BY
g.item_group_name;Задание 2.4: Календарное измерение
💡 Теория: Таблица dim_date
В DWH редко используют функции вроде EXTRACT(YEAR FROM date). Вместо этого используется заранее созданный справочник времени — календарь (dim_date), который связывается с фактами по ключу.
Описание задачи:
Посмотрим динамику заказов по месяцам. Соедините таблицу fact.fact со справочником dim.dim_date по ключу date_key.
Выведите год (year), название месяца (month_name) и общую сумму заказанного товара (total_ordered). Сгруппируйте данные по году и месяцу.
Подсказка: чтобы отсортировать месяцы хронологически, а не по алфавиту, добавьте в сортировку поле номера месяца (month).
SELECT
    d.year,
    d.month_name,
    SUM(f.ordered) AS total_ordered
FROM fact.fact f
JOIN dim.dim_date d
    ON f.date_key = d.date_key
GROUP BY
    d.year,
    d.month_name,
    d.month
ORDER BY
    d.year,
d.month;Задание 3.1: ABC-анализ (Нарастающий итог)
💡 Теория: Оконные функции и CTE
Конструкция WITH (CTE) позволяет создавать временные таблицы в памяти для разбиения сложного запроса на шаги.
Оконная функция SUM(col) OVER (ORDER BY col DESC) позволяет посчитать нарастающий итог (running total) — сумму текущей строки и всех предыдущих. Это основа ABC-анализа.
Описание задачи:
Бизнесу нужно провести классический ABC-анализ товаров по объему доставленных единиц (delivered).
Напишите запрос, который:
- Считает общую сумму доставленного по каждому товару (
item_name). - Считает нарастающий итог и общую сумму по всем товарам.
- Присваивает класс 'A' товарам, которые дают первые 80% объема, 'B' — до 95%, и 'C' — остальным.
WITH (CTE) и конструкция CASE WHEN.
WITH ItemTotals AS (
    -- Шаг 1: Агрегация доставок по товарам
    SELECT
        i.item_name,
        SUM(f.delivered) AS total_del
    FROM fact.fact f
    JOIN dim.dim_item i ON f.item_key = i.item_key
    GROUP BY i.item_name
    HAVING SUM(f.delivered) > 0
),
RunningTotals AS (
    -- Шаг 2: Нарастающий итог и общая сумма оконными функциями
    SELECT
        item_name,
        total_del,
        SUM(total_del) OVER (ORDER BY total_del DESC) AS running_sum,
        SUM(total_del) OVER () AS grand_total
    FROM ItemTotals
)
-- Шаг 3: Вычисление процента и присвоение классов
SELECT
    item_name,
    total_del,
    ROUND((running_sum / grand_total) * 100, 2) AS cum_pct,
    CASE
        WHEN running_sum / grand_total <= 0.80 THEN 'A'
        WHEN running_sum / grand_total <= 0.95 THEN 'B'
        ELSE 'C'
    END AS abc_class
FROM RunningTotals
ORDER BY total_del DESC;Задание 3.2: MoM Динамика (LAG и деление на ноль)
💡 Теория: Функция LAG и NULLIF
Функция LAG(колонка) OVER (PARTITION BY ... ORDER BY ...) позволяет "заглянуть" в предыдущую строку (например, в прошлый месяц) без использования JOIN.
А функция NULLIF(val, 0) спасает от ошибки Division by zero, превращая ноль в NULL.
Описание задачи:
Коммерческий директор просит рассчитать Month-over-Month (MoM) динамику заказов для каждого поставщика (vendor_name).
Выведите поставщика, год, месяц, объем заказов в текущем месяце (current_ordered), объем в предыдущем месяце (prev_ordered) и процент прироста/падения (mom_growth_pct).
Исключите строки, где предыдущий месяц отсутствует (NULL). Убедитесь, что запрос не упадет, если в прошлом месяце заказали 0 штук.
WITH MonthlyStats AS (
    SELECT
        v.vendor_name,
        d.year,
        d.month,
        SUM(f.ordered) AS current_ordered
    FROM fact.fact f
    JOIN dim.dim_vendor v ON f.vendor_key = v.vendor_key
    JOIN dim.dim_date d ON f.date_key = d.date_key
    GROUP BY v.vendor_name, d.year, d.month
),
LaggedStats AS (
    SELECT
        vendor_name,
        year,
        month,
        current_ordered,
        LAG(current_ordered) OVER (PARTITION BY vendor_name ORDER BY year, month) AS prev_ordered
    FROM MonthlyStats
)
SELECT
    vendor_name,
    year,
    month,
    current_ordered,
    prev_ordered,
    ROUND((current_ordered - prev_ordered) / NULLIF(prev_ordered, 0) * 100, 2) AS mom_growth_pct
FROM LaggedStats
WHERE prev_ordered IS NOT NULL;Задание 3.3: Мертвые души (Комплексный Anti-JOIN)
💡 Теория: Поиск отсутствующих данных
Частая проблема DWH — найти то, чего нет в таблице фактов, но есть в справочнике. Это делается через LEFT JOIN фактов к справочнику, с последующей фильтрацией WHERE fact.key IS NULL или агрегацией и проверкой суммы на 0 через COALESCE.
Описание задачи:
Вам нужно найти «мертвые товары» за 2026 год. Это товары, которые существуют в справочнике dim.dim_item, но по ним за весь 2026 год было доставлено ровно 0 единиц (либо записей в таблице фактов за этот год вообще нет).
Выведите название группы товаров (item_group_name) и название товара (item_name).
Запрещено использовать NOT IN, используйте LEFT JOIN.
SELECT
    grp.item_group_name,
    i.item_name
FROM dim.dim_item i
JOIN dim.dim_item_grp grp
    ON i.item_group_id = grp.item_group_id
-- Подзапрос собирает только факты за 2026 год
LEFT JOIN (
    SELECT
        f.item_key,
        SUM(f.delivered) AS total_delivered
    FROM fact.fact f
    JOIN dim.dim_date d ON f.date_key = d.date_key
    WHERE d.year = 2026
    GROUP BY f.item_key
) f2026 ON i.item_key = f2026.item_key
-- Оставляем только те, где поставок нет или сумма = 0
WHERE COALESCE(f2026.total_delivered, 0) = 0;Задание 4.1: Топ-2 внутри каждой группы (PARTITION BY)
💡 Теория: DENSE_RANK и независимые окна
Конструкция PARTITION BY внутри оконной функции делит все строки на независимые "окна" (группы).
Например, функция DENSE_RANK() OVER (PARTITION BY category ORDER BY sales DESC) присвоит 1-е, 2-е, 3-е места товарам внутри каждой категории отдельно. Если категория меняется, счетчик ранга сбрасывается обратно на 1.
Описание задачи:
Директору по логистике нужно узнать главных поставщиков для каждого распределительного центра (РЦ).
Напишите запрос, который выведет Топ-2 поставщиков по сумме доставленного товара (delivered) за 2026 год для каждого РЦ отдельно.
Требования:
- Вывести: название РЦ (
dc_name), название поставщика (vendor_name) и сумму поставок. - Использовать CTE (WITH) для предварительной агрегации сумм.
- Использовать оконную функцию
DENSE_RANK()для определения мест. - Отфильтровать итоговый результат, оставив только 1 и 2 места.
WITH VendorDcStats AS (
    -- Шаг 1: Считаем общую сумму поставок по связке РЦ + Поставщик за 2026 год
    SELECT
        dc.dc_name,
        v.vendor_name,
        SUM(f.delivered) AS total_delivered
    FROM fact.fact f
    JOIN dim.dim_dc dc ON f.dc_key = dc.dc_key
    JOIN dim.dim_vendor v ON f.vendor_key = v.vendor_key
    JOIN dim.dim_date d ON f.date_key = d.date_key
    WHERE d.year = 2026
    GROUP BY dc.dc_name, v.vendor_name
),
RankedVendors AS (
    -- Шаг 2: Ранжируем поставщиков внутри каждого РЦ
    SELECT
        dc_name,
        vendor_name,
        total_delivered,
        DENSE_RANK() OVER (PARTITION BY dc_name ORDER BY total_delivered DESC) as rnk
    FROM VendorDcStats
)
-- Шаг 3: Оставляем только Топ-2
SELECT
    dc_name,
    vendor_name,
    total_delivered
FROM RankedVendors
WHERE rnk <= 2
ORDER BY dc_name, rnk;Задание 4.2: Ошибки Junior-аналитика
💡 Теория: Коварные ловушки PostgreSQL
1. Целочисленное деление: Если в Postgres поделить целое на целое (например, 50 / 100), результат будет 0, а не 0.5. Нужно приводить хотя бы одно число к типу numeric: col1::numeric / col2 или умножать на 1.0.
2. Алфавитная сортировка дат: Если группировать и сортировать по текстовому названию месяца (month_name), то «Август» будет идти раньше «Января». Всегда используйте числовой номер месяца (month) для порядка.
Описание задачи (Troubleshooting):
Младший аналитик написал запрос, чтобы посчитать % выполнения заказа (доставлено / заказано) и нарастающий итог поставок для каждого товара по месяцам 2026 года.
Но бизнес жалуется: «Проценты везде равны нулю, месяцы идут вразнобой, а нарастающий итог считается вообще не по тому товару, а суммирует всё подряд внутри одного месяца!»
Код с ошибками:
SELECT
    i.item_name,
    d.month_name,
    SUM(f.delivered) / SUM(f.ordered) * 100 AS fulfillment_pct,
    SUM(SUM(f.delivered)) OVER (PARTITION BY d.month_name ORDER BY i.item_name) AS cumulative_delivered
FROM fact.fact f
JOIN dim.dim_item i ON f.item_key = i.item_key
JOIN dim.dim_date d ON f.date_key = d.date_key
WHERE d.year = 2026
GROUP BY i.item_name, d.month_name
ORDER BY i.item_name, d.month_name;
Ваша задача: Найдите и исправьте 3 логические ошибки в этом запросе. Напишите правильный SQL.
SELECT
    i.item_name,
    d.month_name,
    -- ИСПРАВЛЕНИЕ 1: Каст к numeric для нормального деления
    ROUND(SUM(f.delivered)::numeric / SUM(f.ordered) * 100, 2) AS fulfillment_pct,

    -- ИСПРАВЛЕНИЕ 2: Окно партицируется по товару, а сортируется по времени (месяцу)
    SUM(SUM(f.delivered)) OVER (
        PARTITION BY i.item_name
        ORDER BY d.month
    ) AS cumulative_delivered

FROM fact.fact f
JOIN dim.dim_item i ON f.item_key = i.item_key
JOIN dim.dim_date d ON f.date_key = d.date_key
WHERE d.year = 2026
-- ИСПРАВЛЕНИЕ 3: Добавлено поле d.month в GROUP BY для корректной сортировки
GROUP BY i.item_name, d.month, d.month_name
ORDER BY i.item_name, d.month;